Mercury 2.5 Cepat, tapi Hanya Benar 13 dari 43 Kata Jawa Langka
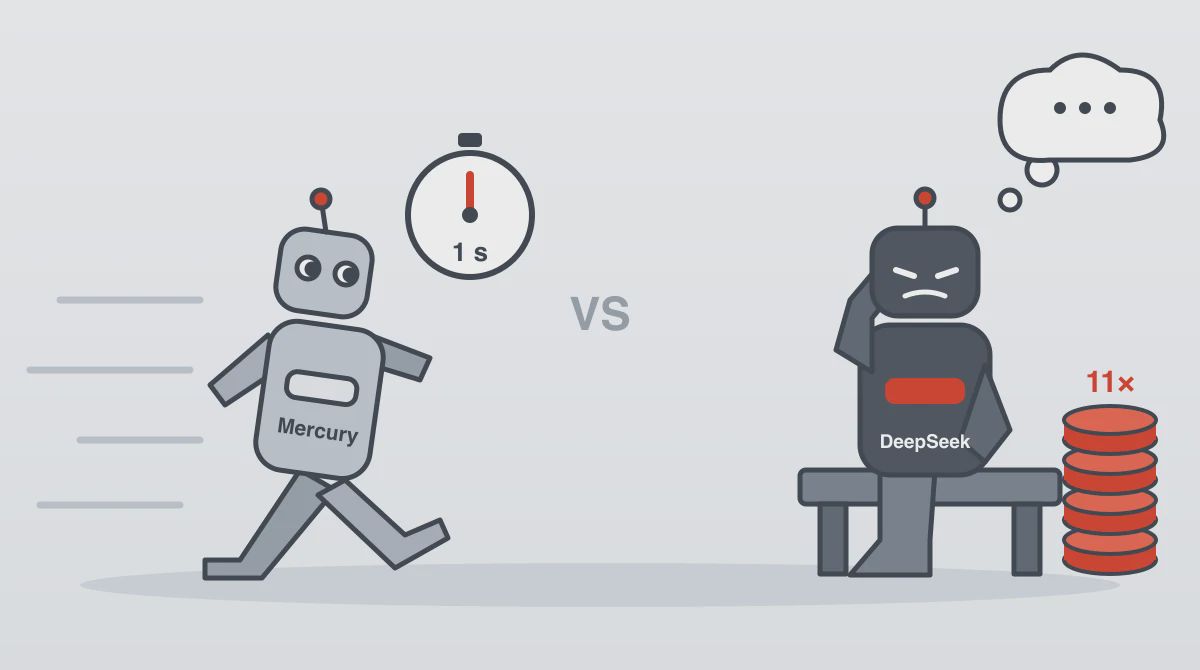
Mercury 2.5 menjual kecepatan, DeepSeek V4.1 Flash menjual penalaran. Di tes kami, kecepatan Mercury terbukti. Penalaran DeepSeek justru menghabiskan token berlipat, sampai di 17 dari 43 kata Jawa langka ia kehabisan batas sebelum sempat menulis jawaban.
Angka kunci
Angka ini dari mana?Diukur dari export-id-B-ringkas-model.csv dan 4 sumber lain
Dua model baru, empat tugas yang sama
Inception merilis Mercury 2.5 pada 8 September 2026. Mercury termasuk model difusi. Model semacam ini tidak menulis jawaban kata demi kata dari kiri ke kanan, melainkan menyusun draf kasar lalu memperbaiki banyak bagiannya sekaligus. Inception mengklaim kecepatan 1.107 token per detik dan kecerdasan yang setara dengan beberapa model, termasuk GPT-5.6 Luna (Low) dan Claude Haiku 4.5. Dua hari kemudian DeepSeek merilis DeepSeek V4.1 Flash, penerus langsung DeepSeek V4 Flash, dengan bobot terbuka berlisensi MIT.
Ibaratnya, model biasa mengetik jawaban dari huruf pertama sampai terakhir, sedangkan model difusi menulis seluruh paragraf sekaligus dalam bentuk kabur, lalu menajamkannya berulang kali.
Kami menjalankan keduanya lewat OpenRouter pada 15 September 2026 di empat tugas dari tiga benchmark: 60 soal pilihan ganda slang Indonesia, 38 soal pilihan ganda dan 8 soal isian terbuka tingkat tutur bahasa Jawa, serta 43 kata Jawa langka. Setiap tugas dijalankan satu kali. Setiap skor di artikel ini menghitung seluruh set, yaitu irisan publik ditambah irisan tertahan (held-out slice) yang tidak pernah kami terbitkan. Jawaban isian terbuka dinilai oleh penutur asli sehari kemudian.
Sebelum satu panggilan pun keluar, kami mengunci 6 prediksi. Hasilnya, 4 kena dan 2 meleset.
| Prediksi | Hasil | Status |
|---|---|---|
| Mercury 2.5 benar 54 sampai 58 dari 60 soal slang | 55 | kena |
| Mercury 2.5 benar paling banyak 30 dari 38 soal tingkat tutur pilihan ganda | 31 | meleset 1 soal |
| Mercury 2.5 benar paling banyak 20 dari 43 kata Jawa langka | 13 | kena |
| Latensi median Mercury 2.5 di slang di bawah GPT-5.6 Luna (1.103 ms) tapi tidak di bawah Gemma 4 31B (614 ms) | 1.041 ms | kena |
| DeepSeek V4.1 Flash berselisih paling banyak 2 soal dari pendahulunya di slang, tingkat tutur pilihan ganda, dan kata Jawa langka | +1, +1, 0 | kena |
| Token keluaran DeepSeek V4.1 Flash antara 0,5 dan 2 kali pendahulunya | slang 4,3×, tingkat tutur 1,7× | meleset |
Angka token slang di prediksi terakhir ikut memuat 2 soal yang diulang dengan batas lebih tinggi, jadi sebagian dari melesetnya berasal dari pengulangan itu.
Mercury 2.5: sekitar 1 detik di setiap tugas
Latensi median Mercury 2.5 bertahan di sekitar 1 detik di keempat tugas, yaitu 1.041 ms di slang, 979 ms di tingkat tutur pilihan ganda, 992 ms di isian terbuka, dan 1.056 ms di kata Jawa langka. Model lain di panel bergerak jauh lebih lebar dari satu tugas ke tugas berikutnya.
Mercury tidak selalu paling cepat. Gemma 4 31B lebih cepat di slang dan di tingkat tutur. Keunggulan Mercury terletak pada kestabilannya. Kata Jawa langka membuat GPT-5.6 Luna melambat hampir 4 kali lipat dibanding soal tingkat tutur, dari 988 ms menjadi 3.708 ms, sementara Mercury nyaris tidak bergeser.
Pola ini kebalikan dari GPT-6 Astra yang kami bahas di artikel sebelumnya. Astra irit token tetapi tidak pernah menjadi yang tercepat. Mercury justru mengeluarkan rata-rata sekitar 260 token per jawaban pilihan ganda, jauh lebih banyak dari satu huruf yang diminta soal, dan tetap selesai dalam sekitar 1 detik. Karena yang kami ukur adalah latensi ujung ke ujung, kami tidak bisa memastikan angka 1.107 token per detik itu. Kami hanya bisa memastikan bahwa kecepatannya terasa di beban kerja kami.
Setara Haiku dan Luna, kecuali di kata Jawa langka
Klaim kedua Inception menyebut Mercury 2.5 setara GPT-5.6 Luna (Low) dan Claude Haiku 4.5. Di dua benchmark pilihan ganda, klaim itu bertahan, karena Mercury berada di antara keduanya.
| Model | Slang Indonesia (60) | Tingkat tutur pilihan ganda (38) |
|---|---|---|
| Claude Haiku 4.5 | 56 (93,3%) | 28 (73,7%) |
| Mercury 2.5 | 55 (91,7%) | 31 (81,6%) |
| GPT-5.6 Luna | 60 (100,0%) | 34 (89,5%) |
73,7
81,6
89,5
Selisih Mercury dengan Claude Haiku 4.5 tidak bisa dibedakan dari derau. Di slang keduanya berbeda jawaban di 3 soal saja, dan di tingkat tutur Mercury unggul di 6 soal sementara Haiku unggul di 3 soal lain. Terhadap GPT-5.6 Luna, Mercury tertinggal 5 soal di slang, tapi selisih itu pun belum cukup untuk disebut nyata (p ≈ 0,06).
Kata Jawa langka mengubah gambarannya. Mercury menjawab benar 13 dari 43 lema, sedangkan GPT-5.6 Luna menjawab benar 35. Claude Haiku 4.5 belum pernah kami jalankan di set ini. Di antara 16 model yang sudah diuji, termasuk MiMo V2.6 Flash yang dijalankan seminggu sesudahnya, Mercury berada di urutan 9, terpaut 1 lema dari GLM 5.3, dan 7 model di bawahnya mendapat 11 atau kurang.
Selisih dengan model di atasnya bukan derau. Dari lema yang dijawab berbeda oleh Mercury dan Luna, Luna benar di 23 lema dan Mercury hanya di 1 lema (p < 0,001). Terhadap Gemma 4 31B perbandingannya 14 lawan 1 (p ≈ 0,001), dan terhadap DeepSeek V4.1 Flash 10 lawan 1 (p ≈ 0,012). Kosakata langka menuntut pengetahuan yang sudah tersimpan di dalam model, dan menyusun jawaban lebih cepat tidak menambah pengetahuan itu. Data kami tidak memisahkan cara kerja difusi dari ukuran model maupun data latihnya, jadi penyebab pastinya belum bisa kami tunjuk.
DeepSeek V4.1 Flash: skor setara, biaya berlipat
Terhadap pendahulunya, DeepSeek V4 Flash, DeepSeek V4.1 Flash menambah 1 soal di slang, 1 soal di tingkat tutur, dan tidak menambah apa pun di kata Jawa langka. Biayanya yang bergerak jauh.
| Tugas | Benar V4 | Benar V4.1 | Biaya V4 | Biaya V4.1 | Rasio biaya |
|---|---|---|---|---|---|
| Slang Indonesia (60) | 57 | 58 | $0,0022 | $0,0195 | 8,7× |
| Tingkat tutur pilihan ganda (38) | 36 | 37 | $0,0020 | $0,0131 | 6,7× |
| Kata Jawa langka (43) | 22 | 22 | $0,0025 | $0,0271 | 10,8× |
Kenaikan skor itu tidak lebih dari pertukaran soal. Di slang, V4.1 benar di 3 soal yang dijawab salah oleh pendahulunya, tetapi salah di 2 soal yang dulu dijawab benar. Di kata Jawa langka keduanya bertukar tepat 1 lema. Ketiga selisih memberi p = 1,00. Token keluarannya juga naik, dari 4.981 menjadi 21.239 di slang dan dari 6.495 menjadi 10.803 di tingkat tutur.
Biaya DeepSeek V4.1 Flash hampir 11 kali lipat untuk menjawab benar 22 kata Jawa langka, jumlah yang sama persis dengan pendahulunya.
Bernalar sampai menabrak batas
Setiap set punya batas token jawaban, dan batas di set kata Jawa langka adalah 600 token. Pada percobaan pertama, DeepSeek V4.1 Flash menabrak batas itu di 17 dari 43 lema.
Setiap kali menabrak batas, jawabannya tidak pernah keluar. Seluruh anggaran habis untuk bernalar sebelum satu kata jawaban pun ditulis. Aturan kami menganggap kasus ini kegagalan teknis, bukan jawaban salah, sehingga lema itu kami tanyakan ulang dengan batas 4 kali lipat. Di batas 2.400 token, 14 lema selesai. Sisa 3 lema baru terjawab di batas 9.600 token dengan 3.388 sampai 4.590 token keluaran. Ketiganya adalah Bladak, Kaleh, dan Sirtu, dan 2 dari 3 jawaban itu tetap salah.
Waktunya ikut memanjang. Latensi median DeepSeek V4.1 Flash di kata Jawa langka mencapai 8.310 ms, hampir 2 kali lipat pendahulunya (4.670 ms). Panggilan terlamanya berlangsung 218.641 ms untuk satu lema, lebih dari 3,5 menit. Kami mengirim anggaran nalar 128 token. Pada 17 lema tadi, DeepSeek V4.1 Flash menghabiskan 600 token tanpa menulis jawaban, jadi anggaran itu jelas tidak berlaku.
Seri di puncak tingkat tutur
Di tingkat tutur pilihan ganda, DeepSeek V4.1 Flash menjawab benar 37 dari 38 soal, sama dengan GPT-6 Astra dan Gemini 3.5 Flash. Gemma 4 31B menyusul dengan 36. Di irisan publik, satu-satunya bagian yang tampil di laman benchmark, keempatnya sama-sama benar 26 dari 27.
Angka seri itu punya satu sebab yang sama. Soal publik yang dijawab salah oleh keempat model itu adalah soal yang sama, dan tidak satu pun dari 19 model di panel kami saat pengujian ini menjawabnya benar. Naskah soal itu tetap tidak kami terbitkan, sama seperti seluruh soal di set ini. Seri di puncak karenanya tidak berarti DeepSeek V4.1 Flash mengalahkan model termahal di panel. Irisan publik set ini sudah tidak sanggup memisahkan model-model terkuat, pola yang sama dengan yang kami temukan di benchmark slang.
Harga tetap membedakan mereka. Satu putaran tingkat tutur pilihan ganda menghabiskan $0,0131 untuk DeepSeek V4.1 Flash, $0,0725 untuk GPT-6 Astra, $0,0795 untuk Gemini 3.5 Flash, dan $0,0006 untuk Gemma 4 31B. Di isian terbuka, penutur memberi DeepSeek V4.1 Flash nilai penuh 8 dari 8 dan Mercury 2.5 nilai 7,75.
Batas kesimpulan
Hasil ini tidak menunjukkan bahwa model difusi lemah di bahasa daerah. Kami menguji satu model difusi pada satu set kosakata yang sengaja dipilih karena langka, sementara di dua benchmark lain Mercury 2.5 setara Claude Haiku 4.5. Hasil ini juga tidak menunjukkan bahwa DeepSeek V4.1 Flash lebih buruk dari pendahulunya, karena skornya imbang di ketiga tugas. Kami tidak menguji koding, penalaran matematika, atau tugas agentic yang mungkin menjadi alasan pembaruan ini.
Angka 1.107 token per detik juga belum terbukti oleh data kami, sebab kami mengukur latensi ujung ke ujung, bukan kecepatan keluaran. Biaya di sini pun tidak berlaku umum. Harga Mercury 2.5 masih diskon peluncuran, dan biaya DeepSeek V4.1 Flash bergantung pada seberapa sering tugas memicunya bernalar panjang.
Data & provenans
- export-id-B-ringkas-model.csv
- export-jv-A-ringkas-model.csv
- export-jv-A-per-item.csv
- export-jv-arti-kata-ringkas-model.csv
- export-jv-arti-kata-hasil-model.csv
Keterbatasan
Satu kali pengujian per model per tugas, tanpa ulangan. Selisih 1 atau 2 soal pada set sebesar ini masih berada di dalam derau antar-pengujian, jadi perbandingan DeepSeek V4.1 Flash dengan pendahulunya sebaiknya dibaca sebagai imbang.
Latensi yang kami ukur adalah waktu ujung ke ujung satu panggilan lewat OpenRouter, termasuk antrean penyedia dan jaringan. Angka itu bukan kecepatan keluaran dalam token per detik, jadi klaim 1.107 token per detik dari Inception tidak kami uji secara langsung.
GPT-5.6 Luna di panel kami dijalankan dengan pengaturan penalaran bawaan, bukan mode Low yang disebut Inception sebagai pembanding Mercury 2.5. Claude Haiku 4.5 belum pernah kami jalankan di set kata Jawa langka.
Harga Mercury 2.5 saat pengujian adalah diskon peluncuran 80 persen. Dengan tarif normal, biayanya sekitar 5 kali lipat angka di artikel ini.
Biaya dan token hanya menjumlahkan panggilan yang berhasil menjawab. Panggilan DeepSeek V4.1 Flash yang menabrak batas lalu diulang, 21 kali di kata Jawa langka dan 2 kali di slang, tidak tercatat biayanya, jadi biaya sebenarnya lebih tinggi dari angka di sini. Angka pendahulunya berasal dari pengujian bulan Agustus, dan jumlah token pendahulu itu di kata Jawa langka tidak tercatat.
Jawaban isian terbuka tingkat tutur dinilai oleh satu penutur asli, tanpa penilai kedua.
Kata Jawa langka berisi 43 lema yang sengaja dipilih karena tidak ada di NusaX, NusaWrites, maupun Wiktionary bahasa Jawa. Skor rendah di sana tidak menggambarkan kemampuan bahasa Jawa sehari-hari.
Riwayat revisi
- Terbit
- Terakhir diperbarui
- belum pernah direvisi sejak terbit
Istilah dalam artikel ini
- agentic
- Sifat model AI yang bertindak sendiri, bukan hanya menjawab sekali: memutuskan langkah berikutnya, memanggil alat, atau mengejar tujuan bertahap tanpa diminta ulang tiap langkah. Kegagalan agentic berarti model salah bertindak saat mengejar tujuan itu, bukan sekadar salah memilih jawaban.
- latensi
- Lama waktu dari permintaan dikirim sampai jawaban lengkap diterima. Perlu dibedakan dari kecepatan mengetik model: angka ini ikut memuat jeda menunggu giliran ketika penyedia sedang penuh, sehingga segelintir panggilan yang bernasib buruk dapat menaikkan reratanya jauh di atas pengalaman sehari-hari.
- lema
- Bentuk dasar sebuah kata yang menjadi tajuk satu entri kamus, dan yang dicari orang saat membuka kamus. Satu lema dapat memayungi beberapa makna sekaligus, dan tiap makna dapat membawa contoh kalimatnya sendiri.
- token
- Potongan teks yang jadi satuan hitung model AI, kira-kira sepanjang suku kata sampai satu kata pendek. Harga layanan AI dihitung per juta token, masuk dan keluar dihitung terpisah, sehingga jawaban yang bertele-tele benar-benar lebih mahal daripada jawaban yang ringkas.
Ditulis penulis untuk artikel ini, bukan disalin dari entri kamus.